- A Microsoft afirma que começará a colocar o Maia 300 em produção em 2027, com implantações de vários gigawatts e potencial para superar um milhão de chips; cronograma e volume são planos, não capacidade já instalada.
- Cada rack reúne 96 aceleradores, 27,6 TB de memória HBM e demanda 167 kW. A empresa promete 40% mais tokens por megawatt que sistemas líderes baseados em GPU, mas não identificou publicamente o comparável usado.
- O movimento busca transformar silício, rede, software e modelos em uma única estrutura econômica. Para clientes do Azure, menor dependência de fornecedores não significa automaticamente maior portabilidade ou preços menores.
A escala anunciada muda a pergunta
A Microsoft apresentou em 12 de outubro o Maia 300, terceira geração de seu acelerador próprio para inteligência artificial. O plano é iniciar implantações de produção em 2027, levar a família Maia a vários gigawatts e torná-la a principal plataforma de inferência dos produtos e serviços da companhia. A Reuters informou que o volume potencial pode superar um milhão de chips no próximo ano.
Esses números descrevem intenção e capacidade buscada, não uma frota já operacional. Fabricação, memória, empacotamento, energia, refrigeração e implantação física ainda precisam convergir. A diferença importa porque um anúncio de silício só se transforma em vantagem quando o sistema entrega cargas reais de forma repetível, com disponibilidade e custo mensuráveis.
O produto é o rack, não apenas o chip
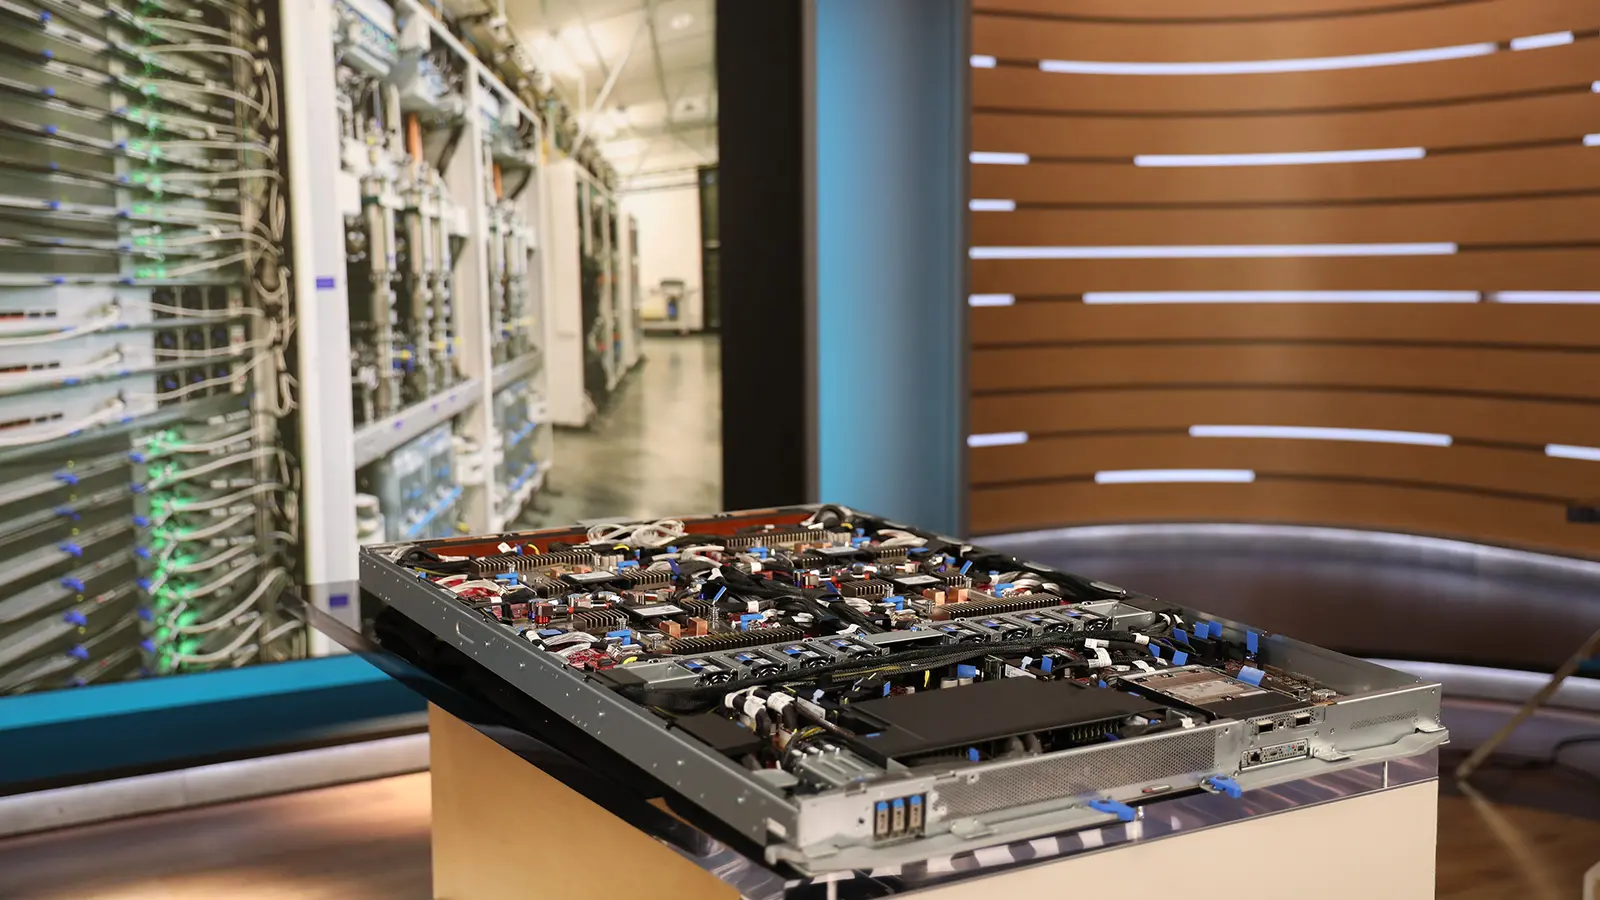
O Maia 300 foi desenhado como sistema de inferência. A Microsoft combina chiplets de computação produzidos no processo N2P da TSMC com funções de memória e entrada e saída em componentes separados. Cada acelerador tem oito pilhas HBM4, 288 GB de memória, 18 TB por segundo de largura de banda e limite térmico de 950 watts, segundo a documentação da companhia.
O conjunto completo reúne 96 aceleradores em um rack de 167 kW, com 27,6 TB de HBM e 1,7 petabyte por segundo de banda agregada. A arquitetura trata rede, memória e movimentação de dados como partes da mesma máquina. Isso revela onde a economia da inferência está mudando: menos no pico isolado de cálculo e mais na capacidade de manter modelos alimentados sem desperdiçar energia movendo dados.
Na inferência em escala, possuir o chip é apenas o começo; a vantagem aparece quando energia, memória, rede, software e carga de trabalho funcionam como um único sistema.
Quarenta por cento é uma promessa que ainda precisa de denominador
A Microsoft espera 40% mais tokens por megawatt que sistemas líderes baseados em GPU e até sete vezes o throughput por rack do Maia 200. A primeira comparação é material para uma empresa que prevê mais de US$ 175 bilhões em investimento de capital neste ano: eficiência energética pode liberar capacidade e reduzir o custo marginal de servir Copilot, GitHub Copilot, Foundry e modelos internos.
Mas a empresa não nomeou o sistema rival usado como referência na afirmação de 40%, e não há benchmark independente de produção para o Maia 300. Tokens por megawatt também variam conforme modelo, precisão, comprimento de contexto, latência e taxa de utilização. Até que esses parâmetros sejam publicados e reproduzidos, o ganho deve ser tratado como expectativa do fornecedor, não como resultado comparável estabelecido.
A dependência muda de lugar
Produzir aceleradores próprios reduz a exposição da Microsoft ao preço e à disponibilidade de Nvidia e AMD. Também melhora seu poder de negociação e permite co-desenhar modelos, compiladores e infraestrutura. O Maia 200 já atende cargas internas em produtos da companhia; o Maia 300 amplia a ambição para raciocínio de contexto longo e tarefas de agentes executadas por períodos prolongados.
Isso não elimina dependências. A fabricação continua ligada à TSMC; a capacidade de memória avançada permanece concentrada; data centers exigem rede, energia e refrigeração; e o software precisa converter modelos para a arquitetura. Verticalização troca uma dependência visível por uma cadeia que a Microsoft controla melhor, mas não controla integralmente.
Para o cliente, menor custo do provedor não garante menor preço
Se o Maia reduzir o custo de inferência, a Microsoft poderá usar a margem para baixar preços, absorver cargas maiores ou financiar novos recursos. Nenhuma dessas escolhas é automática. O benefício econômico pode permanecer dentro da plataforma, principalmente enquanto a demanda por capacidade exceder a oferta e os clientes aceitarem pagar por desempenho, segurança e integração.
Também surge uma questão de portabilidade. Uma carga otimizada para o conjunto Maia, Azure, Foundry e modelos da Microsoft pode ser eficiente dentro desse ambiente e mais difícil de transferir. O chip próprio reduz o lock-in da Microsoft em relação aos fabricantes de GPU, mas pode aumentar o lock-in do cliente em relação à nuvem. A métrica estratégica não é apenas custo por token; é custo por token portátil, auditável e disponível.
O que observar até 2027
Quatro evidências separarão arquitetura de escala real. A primeira é a fabricação: quantos chips serão entregues e em quais regiões. A segunda é operação: disponibilidade, latência e eficiência em modelos identificados. A terceira é economia: preço ou margem por carga comparável. A quarta é acesso: se clientes externos poderão escolher Maia de modo transparente ou se o hardware ficará oculto por trás de serviços gerenciados.
A inferência está se tornando a conta recorrente da IA. Por isso, o Maia 300 é menos uma disputa por prestígio técnico e mais uma tentativa de controlar o custo unitário de cada resposta, tarefa e agente. A Microsoft anunciou um caminho plausível para essa integração vertical. O resultado só existirá quando escala, benchmark e economia aparecerem juntos em produção.
Referências & metodologia
Fontes primárias e confirmações independentes estão listadas abaixo. Fatos, análises e inferências editoriais são identificados separadamente no texto; planos anunciados não são apresentados como resultados concluídos.
- Microsoft to expand Azure Maia system to multi-gigawatt deploymentsMicrosoft · 12 de outubro de 2026
Fonte primária para arquitetura, especificações do rack, metas de eficiência e início previsto das implantações em produção.
- Microsoft's latest custom chip: Maia 300Microsoft News Center · 12 de outubro de 2026
Centro de mídia institucional com fotografias e materiais Web e Print do servidor, sistema e protótipo Maia 300.
- Microsoft plans huge deployment of its own AI chips, with an eye on saving costsReuters · 12 de outubro de 2026
Confirmação jornalística independente para volume potencial, investimento, consumo por rack e ausência de identificação pública do sistema usado na comparação de eficiência.
- Microsoft’s new AI chip makes it less reliant on Nvidia’s GPUsThe Verge · 12 de outubro de 2026
Fonte independente para contexto competitivo, uso do Maia 200 e posicionamento do Maia 300 como plataforma principal de inferência a partir de 2027.
- Microsoft plans to unveil next-generation AI chip in September, The Information reportsReuters · 10 de agosto de 2026
Contexto anterior sobre negociações de capacidade com a TSMC e riscos de componentes e fabricação; os valores prospectivos são tratados como planejamento.