- A Veracode encontrou taxa média de aprovação de segurança de 56% em código gerado por modelos no verão de 2026, enquanto a aprovação sintática chegou perto de 100%.
- O relatório da Sonatype mostra que IA acelera alterações de dependências e pode transformar versões inexistentes, pacotes inseguros e sinais ruins em risco de cadeia de fornecimento na escala de máquinas.
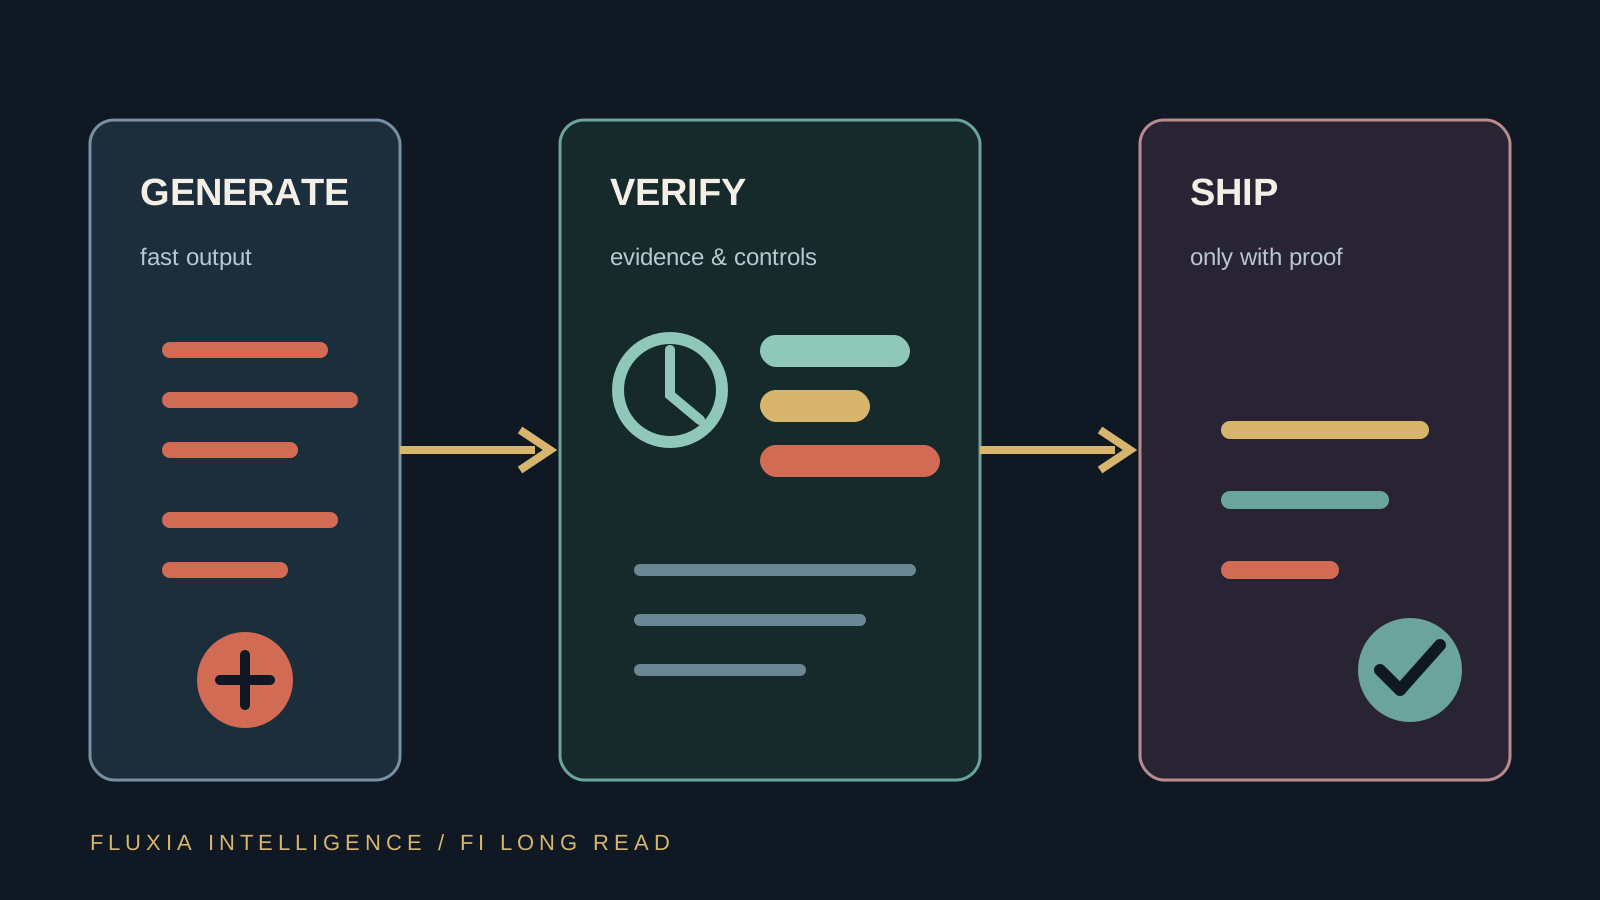
- A tese da Fluxia: quando produzir código deixa de ser o gargalo, revisão, testes, proveniência e observabilidade precisam virar uma camada de produção com orçamento, métricas e autoridade próprios.
A pergunta mudou de ‘a IA consegue programar?’
A discussão sobre agentes de código ainda costuma medir velocidade: quantos arquivos foram alterados, quantos testes passaram ou quantos pull requests chegaram ao fim. Esses indicadores são úteis, mas escondem a mudança mais importante. A geração de código está se aproximando de uma commodity operacional; o recurso escasso é a capacidade de verificar se a mudança é segura, correta, compatível e justificável.
Isso desloca o centro da engenharia. Em vez de tratar revisão como a última etapa depois da produção, empresas precisam tratá-la como infraestrutura: uma combinação de ambientes isolados, testes determinísticos, análise de dependências, políticas, evidências e pessoas capazes de interromper uma implantação.
O que os dados conseguem afirmar
A edição de 2026 do GenAI Code Security Report, da Veracode, avaliou tarefas de código em quatro linguagens e quatro classes de vulnerabilidade. A média de aprovação de segurança ficou em aproximadamente 56%, quase sem mudança em relação às edições anteriores, enquanto a sintaxe chegou a cerca de 99,9%. Em outras palavras: compilar deixou de separar os modelos; escolher implementações seguras continua separando.
A própria metodologia limita a conclusão. São tarefas desenhadas para testar escolhas de segurança em condições controladas, não uma medição de todo agente em produção. Guardrails, contexto do repositório, revisão humana e ferramentas de análise podem alterar o resultado. Ainda assim, a diferença entre sintaxe e segurança é material: código que roda não é evidência de código confiável.
A Sonatype chega por outro caminho. Seu State of the Software Supply Chain 2026 descreve um ecossistema em escala de máquina, com dependências reutilizadas continuamente, inteligência de vulnerabilidades incompleta e novos erros introduzidos por automação. O relatório registra que modelos podem recomendar versões que não existem ou escolhas inseguras quando não consultam uma fonte de verdade atualizada. São estudos de fornecedores diferentes, com métodos diferentes; juntos, apontam para o mesmo gargalo operacional.
A cadeia de fornecimento virou parte do prompt
Um agente não produz apenas funções. Ele escolhe bibliotecas, interpreta documentação, modifica manifests, chama ferramentas, abre pull requests e pode disparar pipelines. Cada passo amplia a superfície de confiança. Uma dependência plausível, mas inexistente, pode quebrar o build; uma dependência real, porém comprometida, pode introduzir risco; um pacote legítimo usado fora do contexto pode criar uma vulnerabilidade que testes superficiais não capturam.
Por isso, a pergunta ‘qual modelo escreve melhor?’ é insuficiente. A empresa precisa saber qual modelo, com quais permissões, em qual ambiente, consultando quais registries e com que evidência de origem. A escolha do modelo passa a ser uma decisão de segurança e de compras, não apenas de produtividade.
A resposta não é proibir geração automática. É reduzir o raio de explosão. O agente deve operar em sandbox, com rede e credenciais mínimas, dependências permitidas por política e acesso somente a fontes verificadas. O resultado precisa carregar proveniência: quem pediu, qual modelo respondeu, quais ferramentas foram usadas, quais testes passaram e qual humano aprovou.
A unidade de confiança não é o trecho de código. É a mudança completa, com origem, contexto, testes e consequência observável.
Verificação não é apenas revisão humana
Revisão humana continua indispensável, mas não escala se for usada para redescobrir todos os fatos básicos de uma mudança. O trabalho deve ser dividido entre controles automáticos e julgamento. Linters, testes unitários, análise estática, scanners de dependência, políticas de licença, assinaturas de artefatos e ambientes efêmeros eliminam classes repetitivas de erro. Pessoas concentram atenção em intenção, impacto e exceções.
O desenho também precisa evitar o falso conforto de uma única métrica. Cobertura de testes não mede qualidade de testes; uma aprovação de segurança em benchmark não garante ausência de falhas no domínio; um review aprovado não prova que o sistema foi observado depois do deploy. A verificação forte combina sinais independentes e registra o que cada um não consegue enxergar.
É aqui que ferramentas como CodeQL, scanners de composição e controles de CI deixam de ser acessórios. O GitHub recomenda executar análise de segurança em cada pull request produzido por IA e restringir explicitamente acesso a arquivos, rede e armazenamento de segredos. A prática transforma a política em um bloqueio técnico, em vez de uma instrução perdida no manual.
A economia do gargalo
Se a geração fica mais rápida e a verificação permanece manual, o custo real da engenharia migra para a fila de revisão. Mais mudanças por equipe não significam mais throughput se o tempo de espera, retrabalho e incidentes cresce na mesma proporção. O indicador certo deixa de ser linhas ou tickets produzidos e passa a ser mudanças seguras por unidade de tempo.
Isso cria uma oportunidade para plataformas internas. Empresas podem oferecer pipelines padronizados, templates de agente, registries aprovados, ambientes de teste e trilhas de auditoria como um serviço compartilhado. O objetivo é reduzir o custo marginal de verificar cada alteração sem retirar a responsabilidade dos times que conhecem o negócio.
A economia também muda a conversa de compra. Um copiloto barato pode ser caro se exigir horas de revisão, correções de vulnerabilidades e investigação de origem. O custo total precisa incluir inferência, execução de ferramentas, armazenamento de logs, segurança, retrabalho e o preço esperado de falhas.
Um modelo operacional para agentes de código
Primeiro, classifique o risco da mudança. Alterações em texto e testes podem ter fluxo rápido; autenticação, pagamentos, dados pessoais, infraestrutura e dependências críticas exigem gates mais fortes. O mesmo agente não deve receber o mesmo nível de autonomia em todos os repositórios.
Segundo, faça o agente provar o trabalho. Cada pull request deve incluir resumo das decisões, arquivos afetados, dependências novas, testes executados, limitações conhecidas e links para evidências. A documentação não é burocracia: é o material que permite ao revisor avaliar intenção em vez de reconstruir o processo.
Terceiro, feche o ciclo depois do deploy. Telemetria, alertas, rollback e revisão de incidentes mostram se os testes representaram a realidade. Quando uma falha aparece, a organização precisa atualizar prompts, políticas, testes e permissões, e não apenas corrigir aquele arquivo. O aprendizado deve voltar para a plataforma.
O que ainda é incerto
Benchmarks de segurança não são comparáveis automaticamente. Tarefas, linguagens, prompts, ferramentas e critérios mudam entre estudos; resultados publicados por fornecedores têm incentivos próprios. A estabilidade da média da Veracode é um sinal importante, não uma taxa universal de vulnerabilidade em código de produção.
Também não é certo que toda empresa precise construir uma plataforma interna completa. Para times pequenos, serviços gerenciados e políticas mínimas podem oferecer melhor relação custo-benefício. O ponto não é a quantidade de ferramentas, mas a existência de controles proporcionais ao impacto e de evidências que sobrevivam a uma auditoria ou incidente.
A tendência, porém, parece mais robusta que qualquer número isolado: agentes aumentam a quantidade e a velocidade das mudanças. Sem melhoria correspondente na verificação, a organização troca tempo de escrita por tempo de triagem e assume risco sem perceber.
Nossa leitura — verificação virou uma capacidade competitiva
A leitura da Fluxia é que a próxima vantagem em engenharia não será simplesmente adotar o agente mais capaz. Será construir o sistema que permite usar vários agentes com confiança: contexto correto, permissões pequenas, fontes de verdade, testes que representam o negócio, revisão baseada em risco e observabilidade pós-implantação.
Essa capacidade é cumulativa. Cada mudança bem instrumentada melhora o catálogo de testes, as políticas e a compreensão do sistema. Cada exceção registrada reduz a dependência de memória individual. Com o tempo, a empresa acumula um ativo difícil de copiar: velocidade com prova.
A decisão prática para líderes é financiar verificação antes de ampliar autonomia. Defina o que o agente pode fazer sozinho, qual evidência precisa produzir e quem pode dizer não. Quando escrever código custa quase nada, a disciplina de provar que ele deve existir passa a ser a fronteira entre escala e fragilidade.
Referências & metodologia
Fontes primárias e confirmações independentes estão listadas abaixo. Fatos, análises e inferências editoriais são identificados separadamente no texto; planos anunciados não são apresentados como resultados concluídos.
- GenAI Code Security Report 2026Veracode · 11 de setembro de 2026
Estudo primário sobre aprovação sintática e de segurança em código gerado por modelos; inclui metodologia e limitações.
- 2026 State of the Software Supply Chain ReportSonatype · 12 de setembro de 2026
Relatório independente de fornecedor sobre dependências em escala, inteligência de vulnerabilidades e riscos ampliados por IA.
- Best practices for using GitHub AI coding agents in your enterpriseGitHub · 13 de setembro de 2026
Orientação oficial sobre sandbox, permissões, revisão e análise de segurança para agentes de código.
- Atlassian introduces always-on capabilities for agentic development workflowsITPro · 12 de setembro de 2026
Cobertura independente de controles de contexto, revisão e métricas para fluxos de desenvolvimento agentic.
- Why AI coding agents need an independent reviewFuturum Group · 01 de julho de 2026
Análise externa sobre a mudança do gargalo de escrita para verificação e a necessidade de revisão independente.