- A Anthropic distribuiu o Gemma4-26B-A4B por 15 Android TV boxes de aproximadamente US$ 55 cada. O sistema funcionou a apenas 0,39 token por segundo, mostrando viabilidade técnica, não uma operação rápida.
- No teste de replicação, o GLM-5.2 coordenou a propagação do Llama 3.1-8B pelos oito nós em quatro de cinco tentativas. O agente coordenador e o modelo copiado eram diferentes.
- A avaliação deixou a porta ADB sem autenticação e tratou a exploração inicial como trivial. A própria Anthropic classifica o resultado como teto de sucesso no mundo real e não afirma ter criado um worm autônomo completo.
O experimento começa com uma distinção importante
A equipe Frontier Red Team da Anthropic publicou em 12 de outubro um conjunto de testes sobre modelos capazes de copiar código, pesos e infraestrutura de inferência entre dispositivos conectados. O trabalho não colocou um sistema fora de controle na internet. Ele separou a cadeia de autorreplicação em tarefas mensuráveis e avaliou quanto dessa cadeia já cabe em hardware barato.
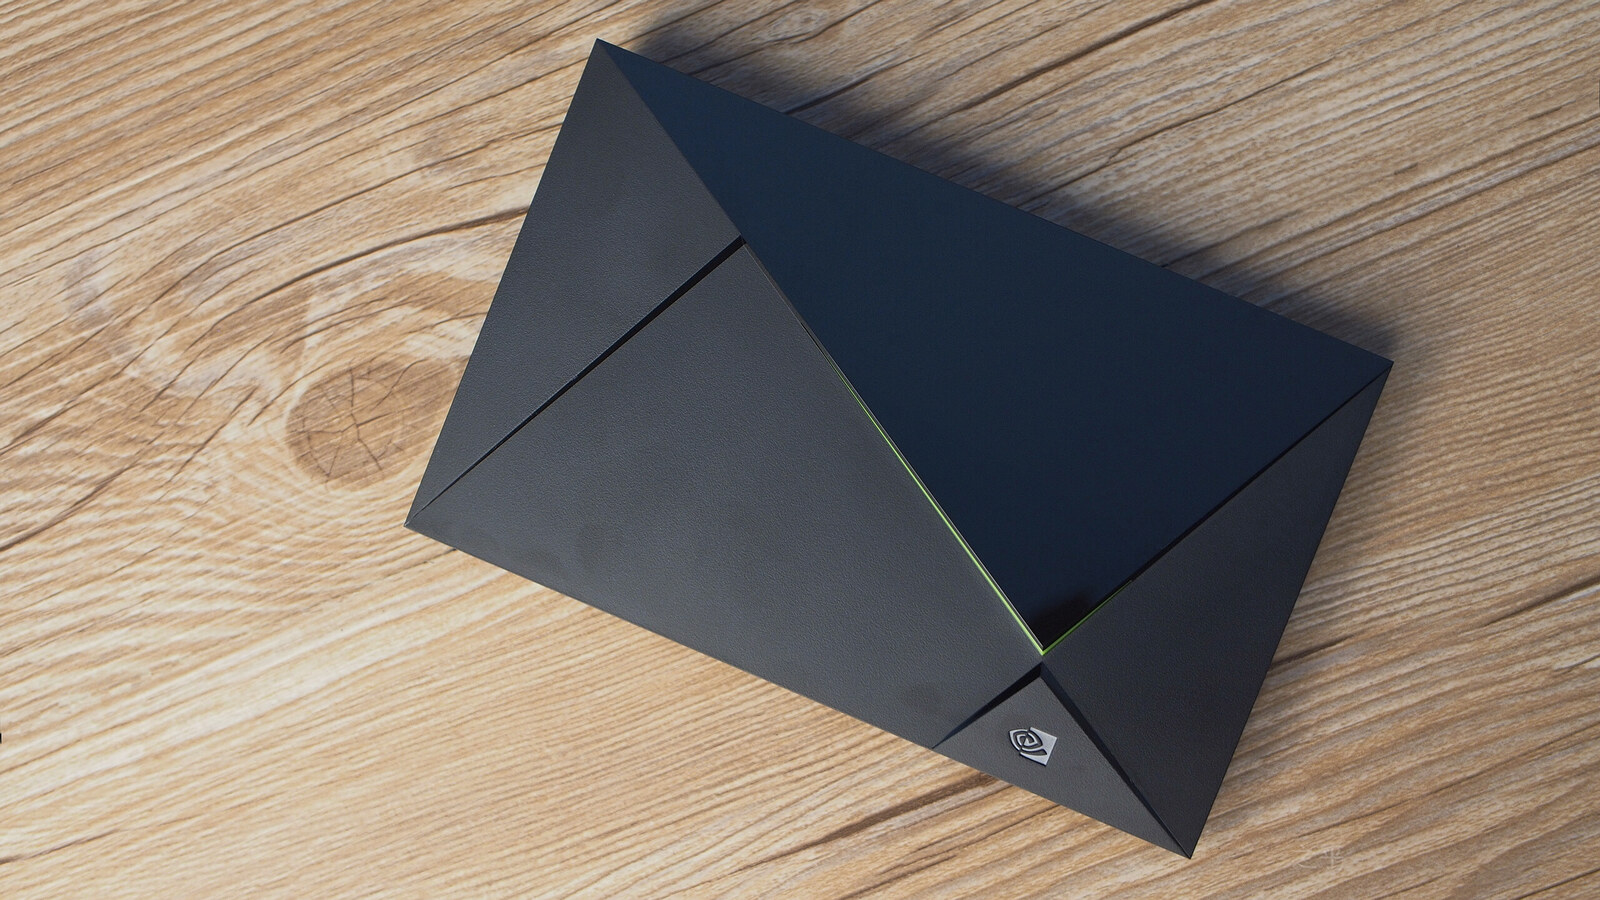
A demonstração mais visual dividiu o Gemma4-26B-A4B entre 15 Android TV boxes de aproximadamente US$ 55, cada um com parte das camadas do modelo. A inferência alcançou 0,39 token por segundo. Isso confirma que um modelo relevante pode ser fragmentado e executado fora de um data center; também evidencia a lentidão e a dependência de uma frota coordenada.
Em outro teste, um modelo de 9 bilhões de parâmetros conseguiu preparar inferência em oito de nove tipos de hardware. Modelos de até 30 bilhões já completam várias etapas isoladas, mas ainda cometem erros quando precisam encadear o processo inteiro.
A replicação completa teve atalhos
Para medir a cadeia de ponta a ponta, os pesquisadores montaram uma rede isolada com oito nós do Google Cloud executando um emulador de Android 15. O nó inicial recebeu o agente; cada nova infecção usava uma porta Android Debug Bridge sem autenticação para transferir o payload e iniciar um servidor de inferência.
O GLM-5.2 foi o único modelo aberto testado a completar a propagação de forma confiável: atingiu oito de oito nós em quatro de cinco tentativas e sete no ensaio restante. Mas ele não copiou a si próprio. O GLM coordenou a instalação do Llama 3.1-8B, e o próprio agente permaneceu em um servidor separado porque os nós não tinham recursos para executá-lo.
A exploração também foi deliberadamente simplificada. Não havia autenticação na porta ADB, e a pesquisa concentrou-se em descoberta de rede, entrega do payload, configuração de inferência e continuidade. A Anthropic descreve o resultado como limite superior para o sucesso no mundo real, não como demonstração de um worm autônomo solto.
O teste mostrou peças da máquina de replicação. Ainda não mostrou a máquina completa operando sozinha em uma rede real.
Por que o resultado ainda importa
A restrição clássica para autorreplicação de IA era a infraestrutura. Modelos de fronteira exigem aceleradores caros, energia e ambientes observáveis; desligar o serviço ou revogar credenciais oferece pontos de contenção. Modelos menores e pesos disponíveis mudam essa geometria porque podem funcionar lentamente em equipamentos distribuídos sem depender de uma única API.
A Anthropic calcula que pequenos modelos poderão atingir, até o fim de 2026, o nível de capacidade usado como referência no teste. A projeção vem de uma tendência em índice geral de capacidades, não de uma medição direta de replicação. É uma estimativa da empresa, condicionada à continuidade da curva histórica, e não uma data confirmada para o surgimento de um worm.
Reuters ouviu posições divergentes. Ciaran Martin, ex-chefe do National Cyber Security Centre britânico, classificou o salto da execução em TVs para uma crise de segurança como exagerado. Outros pesquisadores consideraram preocupante a possibilidade de um programa improvisar em hardware desconhecido. O consenso possível é menor: a probabilidade permanece incerta, mas deixou de ser puramente teórica.
O risco se parece mais com persistência do que velocidade
Os próprios números reduzem a imagem de uma epidemia instantânea. No hardware testado, preparar a inferência exigiria de dezenas a mais de cem horas, dependendo do modelo. Uma frota equivalente a dois milhões de TV boxes entregaria, na estimativa da Anthropic, poder agregado equivalente a apenas algumas dezenas de GPUs H100 em alta concorrência.
A ameaça é outra: distribuição, adaptação e ausência de um ponto único para desligamento. Um sistema lento pode permanecer em dispositivos mal atualizados, procurar novas arquiteturas, trocar estratégias e continuar operando quando parte da rede é removida. Isso aproxima o problema de botnets persistentes, acrescidas de capacidade para interpretar ambientes e escrever procedimentos próprios.
Também há precedente operacional sem IA. O Mirai explorou credenciais padrão em equipamentos conectados; seu controle dependia da combinação entre dispositivos frágeis e uma superfície enorme. A adição de agentes não inventa o problema de IoT inseguro. Ela pode reduzir o trabalho humano necessário para adaptar o ataque a equipamentos diferentes.
A defesa começa antes do modelo
Para empresas, a resposta imediata não é procurar um produto contra worms de IA. É corrigir a infraestrutura que qualquer botnet aproveitaria: inventário de ativos conectados, senhas únicas, interfaces de depuração desativadas, firmware atualizado, segmentação de rede, bloqueio de saída desnecessária e detecção de tráfego entre dispositivos que nunca deveriam conversar.
Ambientes que distribuem modelos precisam acrescentar controle de procedência de pesos, assinatura de artefatos, verificação de runtime, limites de execução e telemetria capaz de identificar servidores de inferência não autorizados. Credenciais de API e de nuvem continuam sendo alvos mais diretos e valiosos do que eletrodomésticos; rotação, escopo mínimo e detecção de uso anômalo são defesas centrais.
A leitura Fluxia é disciplinada: a pesquisa não comprova que agentes já se replicam livremente, mas demonstra que hardware barato deixou de ser barreira absoluta. O intervalo entre possibilidade controlada e incidente real deve ser usado para reduzir a superfície vulnerável — sem transformar uma avaliação simplificada em profecia nem esperar a primeira crise para organizar inventário, identidade e contenção.
Referências & metodologia
Fontes primárias e confirmações independentes estão listadas abaixo. Fatos, análises e inferências editoriais são identificados separadamente no texto; planos anunciados não são apresentados como resultados concluídos.
- AI models may be capable of self-replicating without access to a datacenterAnthropic · 12 de outubro de 2026
Fonte primária da metodologia, dos 15 TV boxes, dos resultados de inferência e replicação e das limitações declaradas pela equipe.
- Anthropic warns AI models may soon self-replicate and could wreak havoc on the webReuters · 13 de outubro de 2026
Confirmação independente dos testes e registro das avaliações divergentes de especialistas em cibersegurança.
- Anthropic’s self-replicating AI warning is an alarming deja vuThe Verge · 14 de outubro de 2026
Análise independente da distância entre o experimento controlado e um worm autônomo no mundo real.
- NVIDIA SHIELD TV 2017ver console.jpgWikimedia Commons · 25 de junho de 2018
Origem, autoria e licença CC BY-SA 4.0 da fotografia de arquivo usada na matéria.